Après une release, l’API renvoie toujours HTTP 200, mais les utilisateurs constatent un ralentissement. Il faut croiser les métriques, les logs et les traces pour en trouver la cause. CloudWatch Omni réunit ces étapes dans un espace centré sur l’application, avec un assistant IA qui interroge la télémétrie disponible.
Ce qu’Omni apporte
AWS a annoncé sa disponibilité générale le 23 septembre 2026. Omni propose une interface web dédiée avec connexion de l’équipe, contexte applicatif et exploration assistée par IA. CloudWatch conserve son rôle de plateforme de données sous-jacente. Annonce AWS.
La carte applicative relie les services et leurs dépendances à partir des signaux disponibles. Des attributs OpenTelemetry cohérents, notamment service.name et service.namespace, rendent ce contexte exploitable. Une relation absente peut aussi révéler une instrumentation manquante. Carte applicative.
On peut demander pourquoi un service ralentit : l’assistant interroge les signaux, montre la requête exécutée et fournit des éléments à examiner. Il aide aussi à composer des dashboards. Ses conclusions restent à vérifier. Assistant Omni.
La différence avec CloudWatch classique
| Point | Parcours CloudWatch existants | Parcours Omni |
|---|---|---|
| Point de départ | Vues console, dashboards et requêtes | Espace d’équipe avec contexte applicatif |
| Investigation | Navigation entre métriques, logs et traces utiles | Exploration des signaux et questions contextualisées |
| Base de données | Collecte et stockage CloudWatch | Lecture de la télémétrie configurée pour l’espace |
| Périmètre opérationnel | Alarmes, API et dashboards existants conservés | Ajout de ses propres alertes, threads et parcours d’enquête |
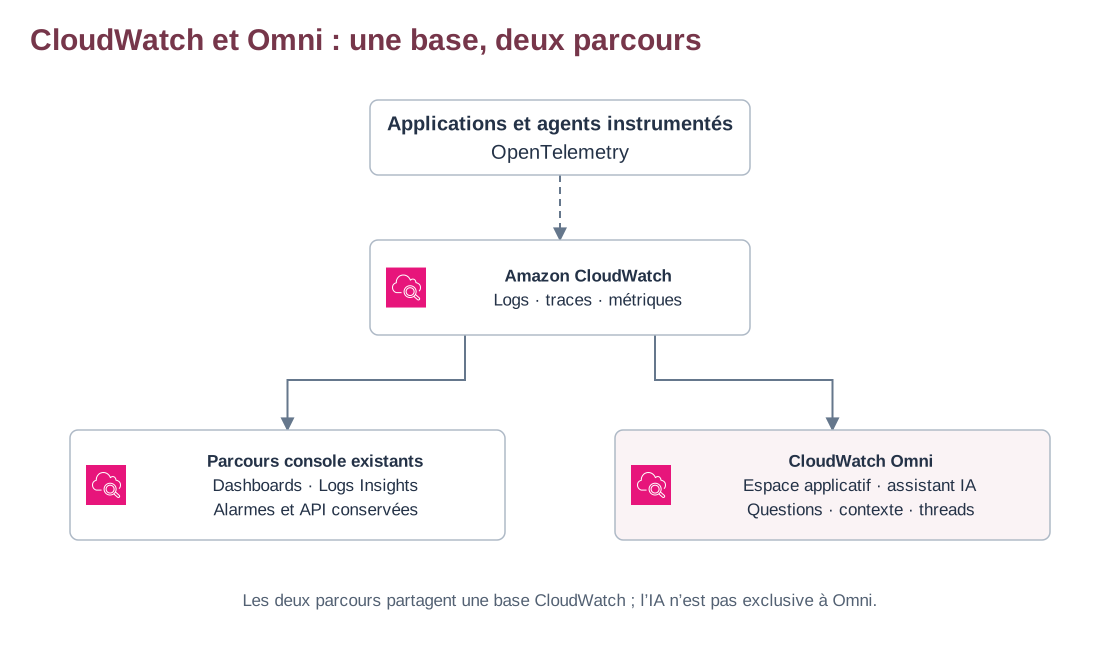
L’IA et la corrélation existent aussi dans les autres outils CloudWatch. Omni ajoute un espace d’investigation ; les dashboards et alarmes existants restent disponibles. Un espace est lié à un compte et une région. La visibilité multicomptes ou multirégion nécessite toujours une configuration de centralisation CloudWatch. Lien avec CloudWatch.
Les cas d’usage pour les équipes Cloud et DevOps
Une régression après déploiement. Comparer la fenêtre de release avec la latence HTTP et les spans du client PostgreSQL. Demander quelle dépendance explique le temps supplémentaire, puis vérifier la trace et les éléments côté base avant de décider d’un rollback.
Un incident entre plusieurs services. Sur une application ECS ou EKS instrumentée, utiliser la carte pour repérer les dépendances affectées et organiser l’enquête autour du service et de la période concernés.
Un agent IA qui répond mal. Un statut HTTP réussi ne suffit pas à mesurer la qualité. Omni propose des traces et des évaluations d’agents pour rapprocher qualité, latence et appels d’outils. Les évaluateurs sont fournis par AgentCore Evaluations. Observabilité des agents.
Un parcours d’investigation réaliste
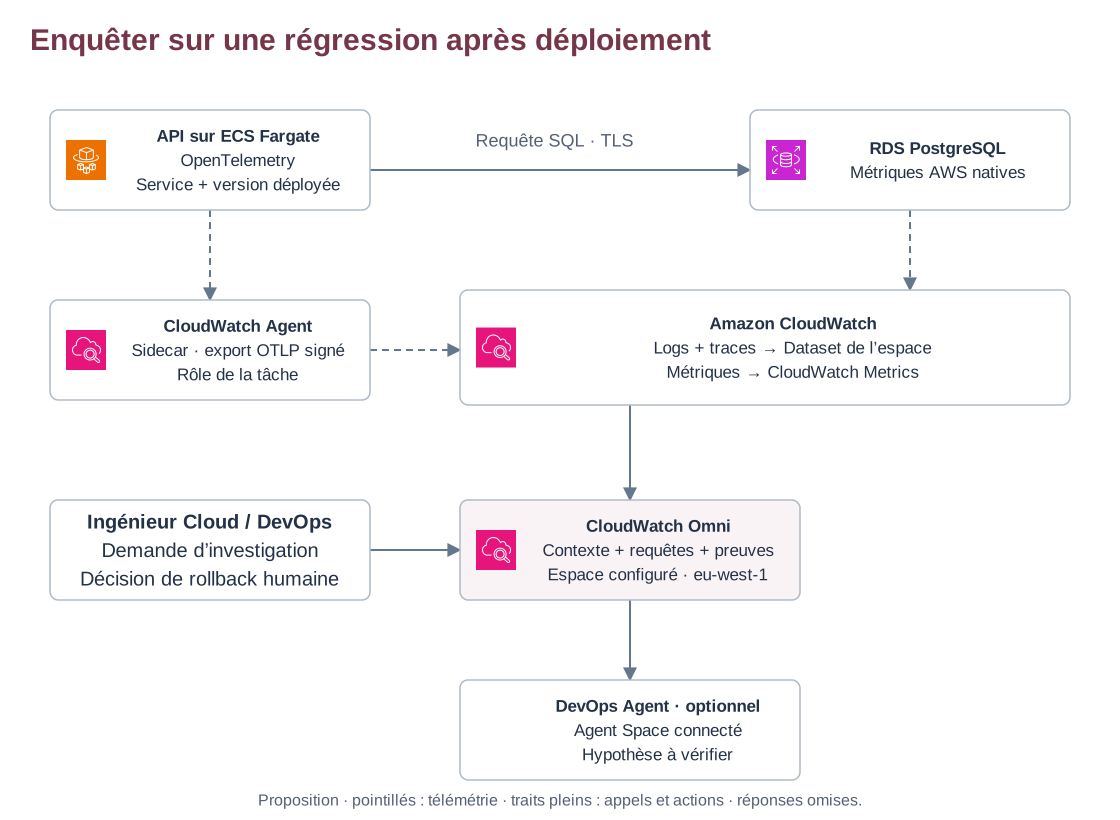
Dans cette proposition de staging, une API Fargate instrumentée appelle RDS PostgreSQL. Un sidecar CloudWatch Agent exporte la télémétrie applicative avec les droits de son rôle. Les logs et traces rejoignent le Dataset de l’espace ; les métriques sont interrogées dans CloudWatch Metrics. Transaction Search doit être activé pour les traces. Acheminement de la télémétrie.
Une personne sélectionne la fenêtre de release et demande une investigation. Les enquêtes natives avec DevOps Agent nécessitent un Agent Space connecté. Une alerte Omni ne démarre pas automatiquement une investigation lorsqu’elle se déclenche. Dans cette expérience, le déploiement ou le rollback reste une décision de l’opérateur. Intégration des investigations.
Ce que cela change au quotidien
Build : stabiliser les noms de service, instrumenter les dépendances importantes et enregistrer la version déployée. C’est le point de départ d’une enquête exploitable.
Run : utiliser l’assistant pour retrouver des éléments, puis examiner ses requêtes et ses traces. Vérifier une cause supposée avec des signaux indépendants et le comportement après correction. L’assistant utilise les droits d’accès de l’utilisateur à la télémétrie et peut se tromper. Droits et limites.
Équipe plateforme : configurer les accès à l’espace, le périmètre des données et leur rétention. Éviter les informations sensibles dans les logs et évaluer le coût complet de collecte, stockage et évaluations avant d’élargir l’usage. Une régression connue en staging constitue un bon premier test, avec une hypothèse et des éléments attendus définis à l’avance.
Les instructions de déploiement, de rollback et de nettoyage restent dans le lab détaillé, avec un starter du POC téléchargeable. Ce lab est une proposition ; aucun déploiement, benchmark ou gain de MTTR n’est présenté comme réalisé.
Cloud, DevOps et agents IA. Le journal Kloud.
Retour au journal